
Medeoprichter van Media52 en hoogleraar Journalistiek, bouwt aan IO+, events en Laio, met focus op commerciële kansen—en blijft schrijven voor IO+.
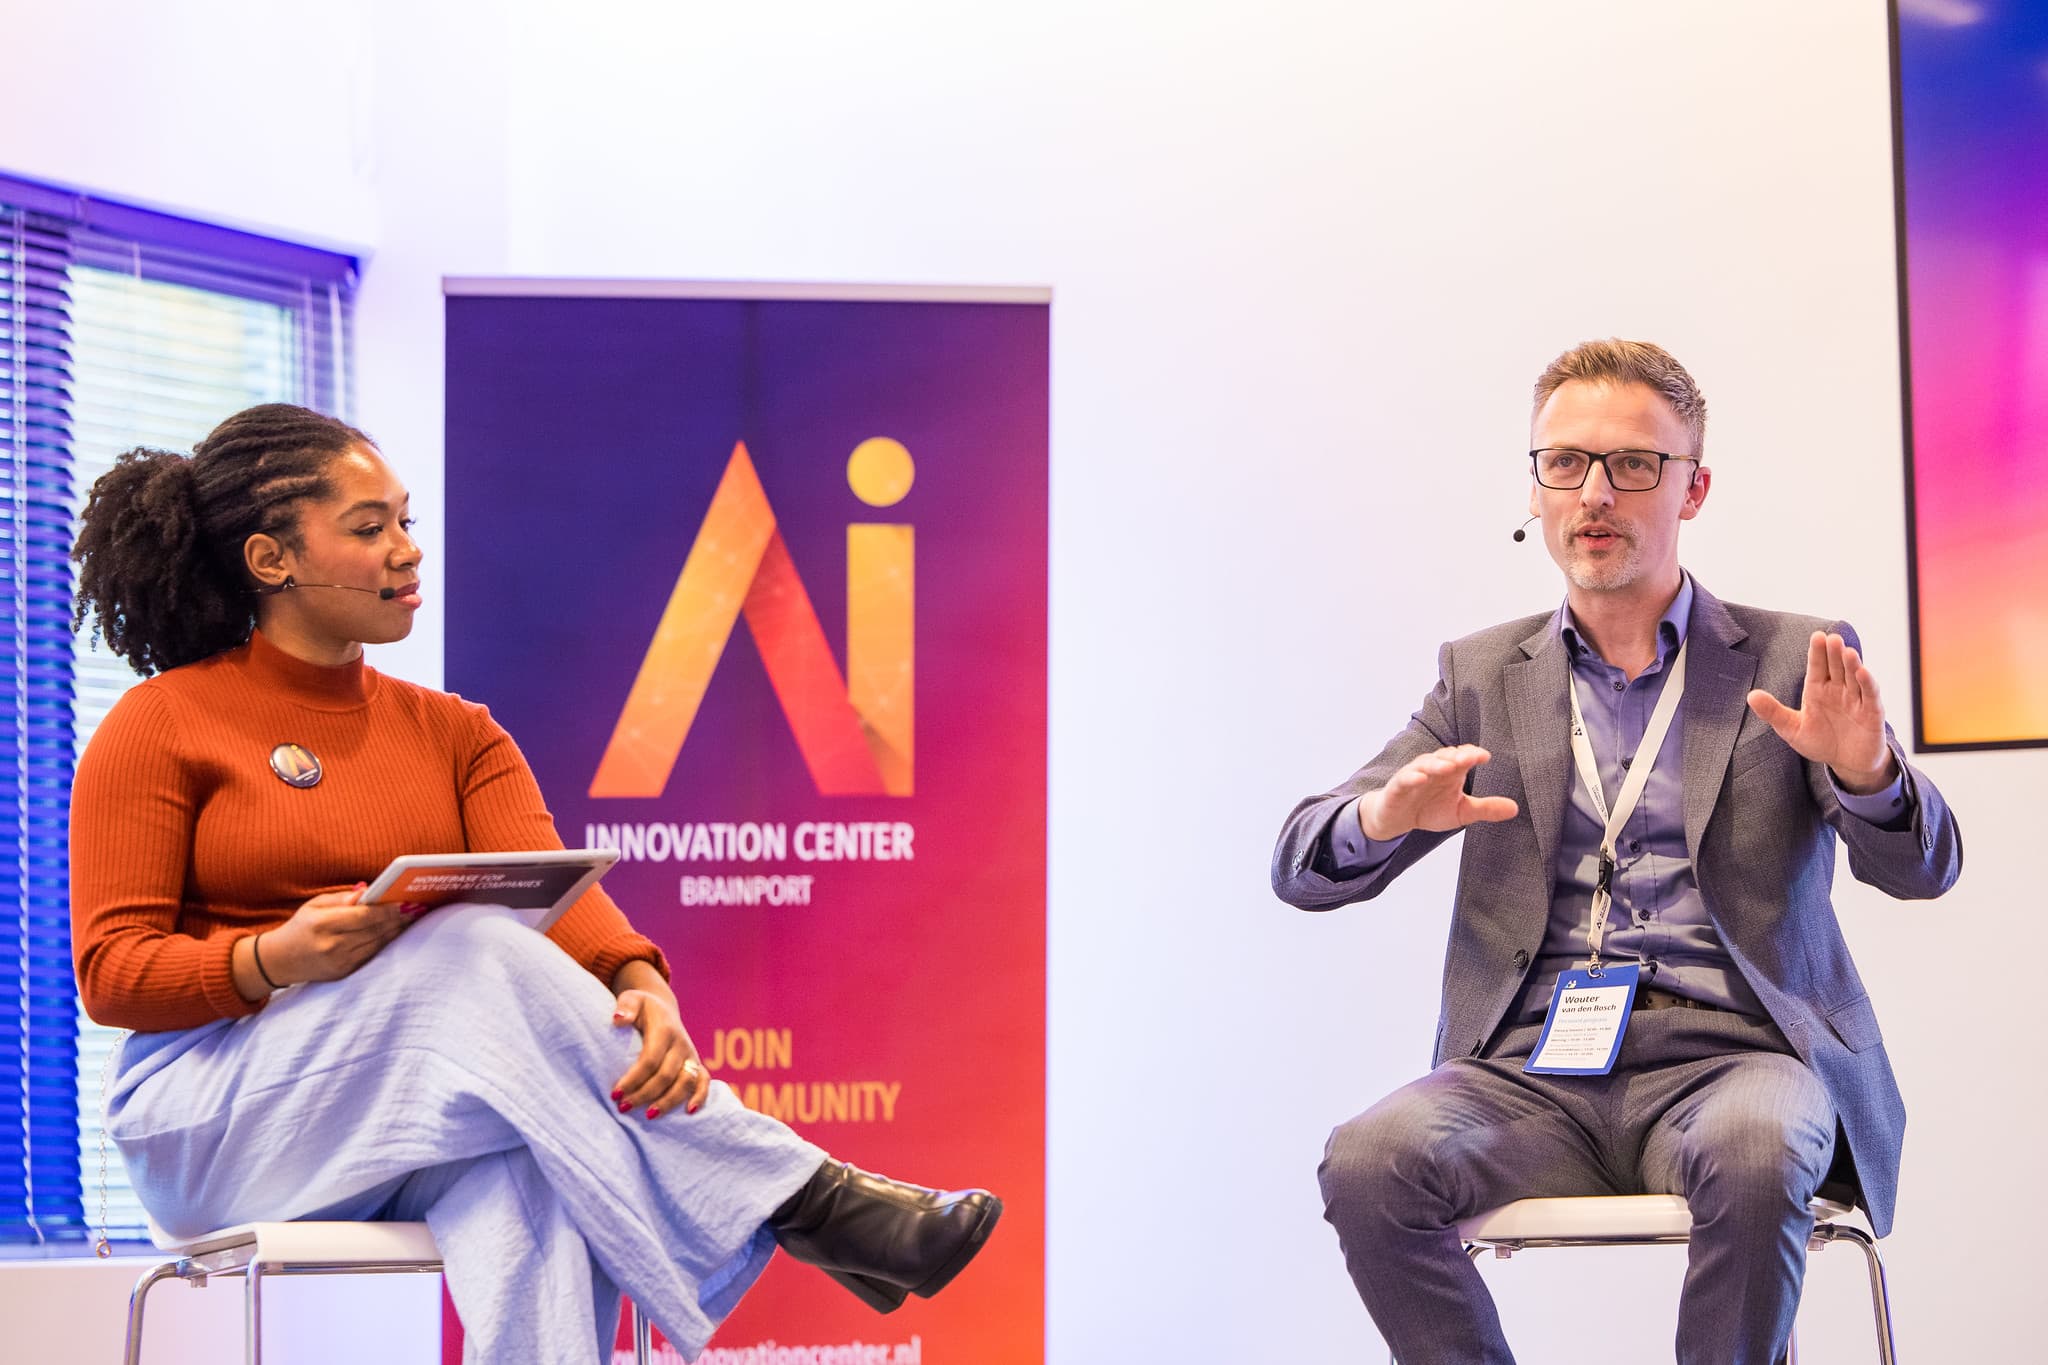
Wouter Van den Bosch kent het soort LinkedIn-post maar al te goed. Iemand krijgt een AI-programmeeragent aan de praat op een laptop, neemt die mee in het vliegtuig en plaatst een foto waarop te zien is hoe die hoog in de lucht zit te programmeren. Van den Bosch kan die prestatie wel waarderen. Maar op de AI Summit Brainport stelde de AI-productdirecteur van imec een lastigere vraag. Wat gebeurt er als een heel softwareteam die agent tegelijk nodig heeft?
Een programmeur in het vliegtuig kan best wat langer op een antwoord wachten. Maar als op maandagochtend tientallen mensen op dezelfde machine zitten te wachten, kost die vertraging al snel werktijd. Koop je voldoende hardware voor het drukste uur, dan staat een deel daarvan ’s nachts misschien stil. Ook die kosten moeten bedrijven meenemen, zei Van den Bosch op 12 november tijdens de AI Implementation Track in het Eindhovense Evoluon.
Wat doet de GPU als iedereen naar huis is?
Een jaar geleden maakten de bedrijven die Van den Bosch sprak zich zelden druk over de kosten van tokens, de stukjes tekst die modellen verwerken en genereren. Dat is veranderd nu steeds meer mensen programmeerassistenten gebruiken en bedrijven taalmodellen in hun eigen producten inbouwen. Elke extra klant die een AI-functie gebruikt, kan de rekening verhogen. En hoe hoger die rekening, hoe aantrekkelijker het wordt om GPU’s te kopen of te huren en de modellen zelf te draaien.
Het aistack-team van imec nam de proef op de som. Het legde 64 programmeeropdrachten voor aan modellen die draaiden op uiteenlopende configuraties, van één GPU tot servers met meerdere GPU’s en commerciële diensten. Het kleinere model dat op één GPU paste, loste ongeveer een derde van de opdrachten op. Het commerciële referentiemodel loste er 40 op. Een groot model met openbaar beschikbare modelgewichten evenaarde die score, maar had in de geteste opstelling een server met acht Nvidia B200-GPU’s nodig.
Dan blijft de vraag hoe lang die GPU’s daadwerkelijk aan het werk zijn. Een cloudaanbieder kan klanten in verschillende tijdzones bedienen. Bij een bedrijf dat een tool voor eigen medewerkers draait, kan de vraag juist tijdens kantooruren concentreren. Voor de configuraties die imec testte, lagen de kosten van kopen en huren ongeveer in dezelfde orde van grootte zodra het werkelijke gebruik werd meegerekend. Wie alleen naar de piekvraag kijkt, mist de uren waarin de apparatuur stilstaat.
De software rond het model kan de rekening veranderen
“We hebben op een gegeven moment getest wat er gebeurde als we bij een groot taalmodel alleen de harness vervingen”, zei Van den Bosch. De harness is de software die een model bestanden laat lezen en bewerken, tests laat uitvoeren en bepaalt welke informatie het model tijdens het werk terugkrijgt. Die keuzes bepalen mede hoeveel tekst het model verwerkt om tot een antwoord te komen.
In een van Van den Bosch' vergelijkingen losten twee harnesses met hetzelfde GLM-model respectievelijk 33 en 32 van de 64 programmeeropdrachten op. De eerste verwerkte ongeveer 192 miljoen invoertokens. De tweede gebruikte er ongeveer 480 miljoen. Van den Bosch waarschuwde dat de beste combinatie binnen enkele maanden kan veranderen, doordat zowel het model als de software eromheen zich verder ontwikkelt.
Iemand uit het publiek bracht het gesprek terug naar de werkvloer. De organisatie betaalde voor tools en trainingen, maar hoe kon ze vaststellen wat die opleverden? Van den Bosch zou beginnen met het gebruik zichtbaar te maken. Welke afdelingen verbruiken de meeste tokens, voor welke taken en waar lopen de kosten op? Test vervolgens alternatieven op het eigen werk en kijk welke taken ze daadwerkelijk afhandelen. Een bedrijf kan beginnen met één programmeerproces en een commerciële dienst blijven gebruiken voor de taken die deze het beste uitvoert.
Dezelfde vraag speelt bij de chipontwerper
Voor imec zijn die metingen ook een paar lagen dieper van belang. Als een programmeeragent tussendoor informatie op internet opzoekt of een bestand wegschrijft, kan een dure GPU stilstaan terwijl de CPU het werk doet. Dat gebruikspatroon telt mee voor een chipontwerper die moet bepalen hoeveel ruimte er naar geheugen en rekenkracht gaat en hoe gegevens tussen chips worden verplaatst.
Van den Bosch noemde onder meer Axelera AI, NXP en imec-spin-off Vertical Compute als voorbeelden van expertise die Europa kan samenbrengen. Hij wil chipmakers, systeembouwers en AI-ontwikkelaars aan tafel krijgen om te bespreken waar hun componenten goed in zijn en wat toekomstige modellen nodig hebben. Hij ziet ook een financieringskloof zodra zulke combinaties gebouwd en op grote schaal op de markt gebracht moeten worden.
Het AI-team dat zijn maandelijkse factuur opent en de chipontwerper die jaren vooruit zijn ontwikkelplannen vastlegt, werken met verschillende termijnen. Beiden moeten weten wat de software doet zodra mensen ermee aan de slag gaan. De laptop in het vliegtuig bewijst dat de agent kan draaien. Op maandagochtend blijkt hoeveel werk die aankan, hoeveel mensen er tegelijk mee kunnen werken en wat dat kost.