
‘Europa heeft fabrieken en machinebouwers; wat ontbreekt is data’
Hoe Synthgen fysieke AI traint met de zeldzame uitzonderingsgevallen die ertoe doen: ‘We lossen probleem op dat elk inspectieteam herkent.’
Published on October 16, 2026
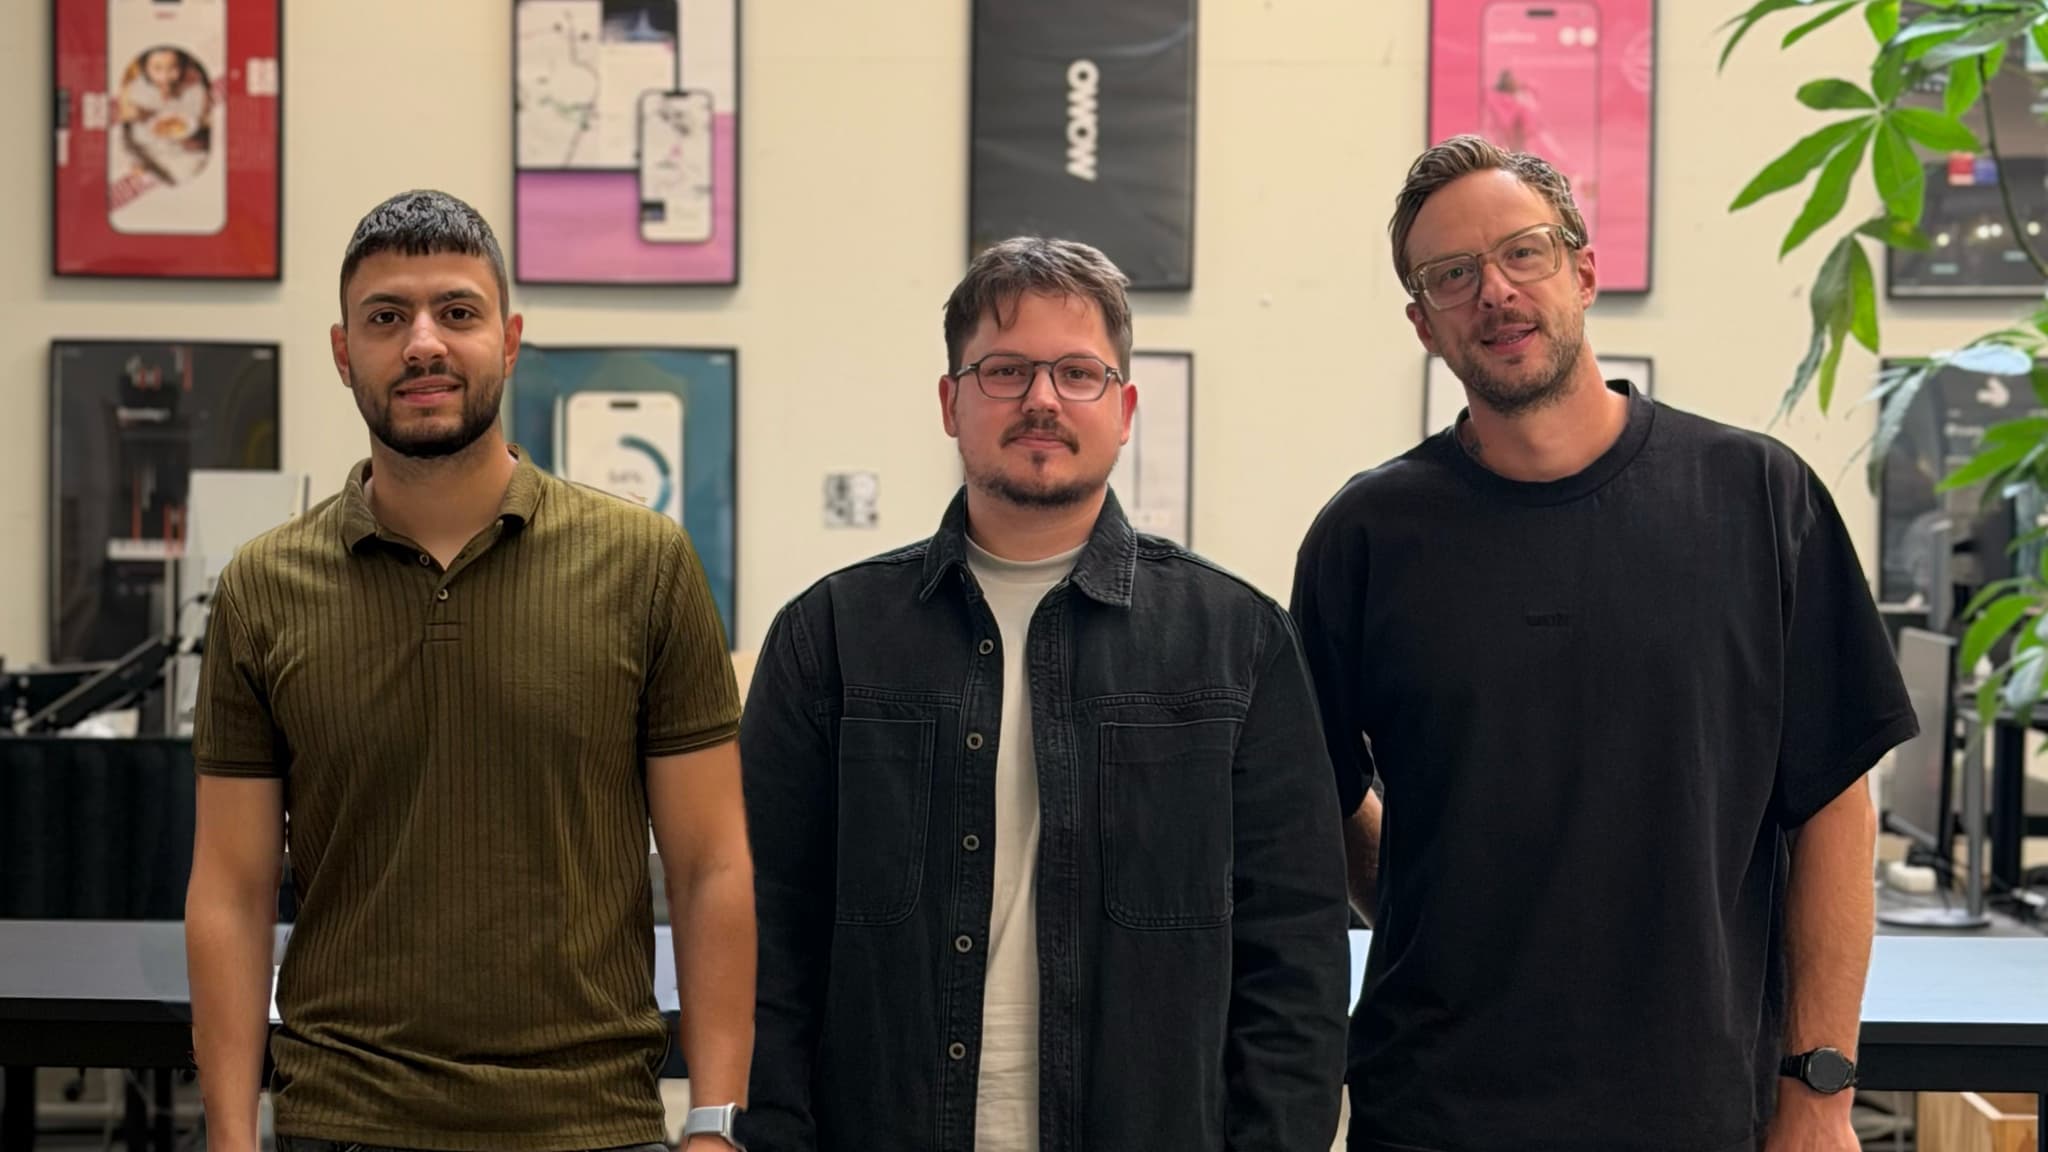
Founders © Synthgen
Medeoprichter van Media52 en hoogleraar Journalistiek, bouwt aan IO+, events en Laio, met focus op commerciële kansen—en blijft schrijven voor IO+.
In aanloop naar de finale van de AI Pitch Competition op 12 november in het Evoluon in Eindhoven zet IO+ zijn verdiepende serie over de acht finalisten en één wildcard voort. In deze tweede aflevering vertelt Martin Tomov, CTO en medeoprichter van Synthgen, hoe de Brainport-startup tot op de pixel nauwkeurige synthetische data genereert voor fysieke AI. Daarmee richt het bedrijf zich op defecten, gewasziekten en lasscheuren die te zeldzaam zijn om in de praktijk voldoende vast te leggen.
Wanneer een autonome landbouwrobot een akker verkent, een industriële camera razendsnel farmaceutische verpakkingen controleert of een röntgensysteem een motoronderdeel inspecteert, moet het camerasysteem onmiddellijk beslissingen nemen. Maar juist de belangrijkste afwijkingen komen het minst voor: een minuscuul haarscheurtje in een pil, een ziekteverwekker in een vroeg stadium op één enkel blad of een inwendig lasdefect dat maar drie keer per jaar optreedt.
Omdat het vrijwel onmogelijk is om duizenden echte foto’s van deze afwijkingen te verzamelen, zien gangbare machinelearningmodellen ze geregeld over het hoofd. Synthgen, gevestigd in het Brainport-ecosysteem rond Eindhoven, pakt dit knelpunt direct aan. De startup genereert synthetische trainingsdata voor precies die uitzonderingsgevallen waarvoor beeldherkenningssystemen onvoldoende voorbeelden hebben, en voorziet die automatisch van labels.
Martin Tomov legt uit hoe de technologie werkt, hoe het bedrijf diepgewortelde scepsis in de industrie overwint en waarom synthetische data essentieel zijn voor de Europese soevereiniteit op het gebied van fysieke AI.
Het knelpunt van zeldzame gevallen in fysieke AI doorbreken
‘Fysieke AI, oftewel robots, inspectiesystemen en machines die kunnen zien, leert van beelden uit de echte wereld’, legt Tomov uit. ‘De gevallen die er het meest toe doen, zijn vaak het zeldzaamst: een scheurtje in een capsule, een ziekte op een blad, een lasdefect dat een paar keer per jaar voorkomt. Niemand kan daar voldoende beelden van verzamelen, waardoor modellen ze missen.’
In plaats van wekenlang handmatig data te verzamelen of eindeloos kaders rond objecten in beelden te tekenen, genereert Synthgen de ontbrekende variaties rechtstreeks op basis van bestaande klantdata.
‘Synthgen genereert die beelden’, zegt Tomov. ‘Onze technologie leert op basis van de eigen beelden van een klant hoe een defect of een zeldzame situatie eruitziet, maakt nieuwe voorbeelden met de variaties die het model nodig heeft en labelt elke pixel automatisch. We combineren het genereren van 3D-scènes met generatieve modellen. Actief leren bepaalt vervolgens welke voorbeelden het model nodig heeft. Klanten behouden hun camera’s en software; wij voegen de data toe.’
Het effect op de betrouwbaarheid van modellen is meetbaar en direct zichtbaar in uiteenlopende productieomgevingen: ‘In onze tests in acht sectoren verbeterde het toevoegen van onze synthetische data in alle gevallen de nauwkeurigheid voor de moeilijkste categorie. De vooruitgang varieerde van 9 tot 35 procentpunten, afhankelijk van de dataset. Bij opdrukken op farmaceutische pillen steeg de nauwkeurigheid bijvoorbeeld van 46 naar 81 procent.’
Vertrouwen opbouwen op de fabrieksvloer
De generatieve aanpak van Synthgen werkt ongeacht of een beeld een industrieel onderdeel, een medische scan of een akker laat zien. Daardoor kan de onderliggende technologie eenvoudig worden opgeschaald, zonder voor elke toepassing opnieuw te moeten worden ontwikkeld. De voorzichtige inkoopprocessen in de maakindustrie vragen wel om geduld.
‘De methode werkt hetzelfde, of de beelden nu van een productielijn, een landbouwrobot of een medische scanner komen. We hoeven het product dus niet voor elke klant opnieuw te bouwen’, legt Tomov uit. ‘Een nieuwe categorie wordt tegelijk gegenereerd en gelabeld, en de getrainde modellen draaien in een datacenter of op een klein apparaat ter plaatse.’
‘De grootste uitdaging is vertrouwen’, vervolgt hij. ‘Elke fabrikant denkt dat zijn situatie uniek is, en vaak klopt dat ook. Daarom begint elke klant met een beoordelingstraject van vier weken op basis van de eigen beelden, voordat die zich aan een vervolg verbindt. Daardoor verloopt de verkoop langzamer dan bij pure software, maar zo kopen industriële bedrijven nu eenmaal in. De tweede uitdaging is dat klanten hun data streng bewaken. Onze infrastructuur moet aan hun eisen voldoen voordat we grotere klanten kunnen bedienen.’
Strenge validatie: ‘overtuigende’ hallucinaties voorkomen
Bij visuele inspectie is een realistisch ogend synthetisch beeld gevaarlijk als het een neuraal netwerk op het verkeerde been zet. Synthgen hanteert daarom een strikt validatieprotocol: gegenereerde data moeten hun waarde bewijzen aan de hand van echte beelden die apart zijn gehouden.
‘Synthetische data kunnen er overtuigend uitzien en een model toch het verkeerde aanleren’, waarschuwt Tomov. ‘Als onze defecten niet overeenkomen met de werkelijkheid, kan een model slagen voor zijn tests en vervolgens echte defecten op de productielijn missen. Daarom toetsen we elke dataset aan echte klantbeelden die niet voor de training zijn gebruikt. Het model moet daarop beter presteren voordat we iets opleveren.’
Ook de vertrouwelijkheid van data is bij industrieel intellectueel eigendom ononderhandelbaar: ‘Vertekening betekent in ons vakgebied meestal dat het zeldzame geval ondervertegenwoordigd is. Door daar meer voorbeelden van te genereren, herstellen we die onbalans. Klantbeelden worden nooit gedeeld, nooit hergebruikt voor andere klanten en nooit gebruikt om iets anders te trainen dan het eigen model van die klant.’
De drempel verlagen voor kleinere fabrikanten
De maatschappelijke en economische gevolgen van onopgemerkte gebreken zijn aanzienlijk: verloren oogstopbrengsten, afgekeurde metalen onderdelen, terugroepacties en risico’s bij medische diagnostiek.
‘Gemiste defecten leiden tot terugroepacties, voedselverspilling, afgekeurde onderdelen en, bij medische beeldvorming, risico’s voor patiënten. Betere detectie vermindert al die gevolgen’, merkt Tomov op. ‘En omdat we veel minder echte voorbeelden nodig hebben, kunnen ook kleinere fabrikanten en telers die zich geen maandenlange dataverzameling kunnen veroorloven, AI-inspectie inzetten.’
Tegelijkertijd waakt het team voor blind vertrouwen in de uitkomsten van AI: ‘We maken ons zorgen over te veel vertrouwen: een model dat er op papier goed uitziet en zonder voldoende controle in productie wordt genomen. We vertellen klanten waar synthetische data helpen en waar niet, en we rapporteren resultaten ook als de verbetering klein is.’
Een Europees alternatief voor modellen uit Silicon Valley
Wie een industriële deeptech-startup begint, moet eerst zijn geloofwaardigheid bewijzen, zeker tegenover ervaren fabrieksingenieurs.
‘Onze grootste hindernis was scepsis’, blikt Tomov terug. ‘Ingenieurs in de maakindustrie hebben al veel AI-beloften gehoord, en “synthetische data” klinkt voor velen te mooi om waar te zijn. We hebben dat doorbroken door klein te beginnen: één moeilijke categorie, hun eigen beelden en een meetbaar resultaat.’
Het team koos ook bewust voor een andere positionering dan de grote Amerikaanse AI-labs: ‘De grote generatieve modellen komen vooral uit de VS en zijn gebouwd voor internetbeelden, niet voor röntgenfoto’s, gewasrijen of een voedselproductielijn. Europese fabrikanten, telers en ziekenhuizen hebben een partner nodig die hun vakgebied begrijpt en hun data in Europa houdt. Daarom willen we de Europese leider worden in synthetische data voor fysieke AI, te beginnen waar Europa al sterk in is: hightech-maakindustrie en landbouw.’
AI Pitch Competition
Lees hier alle artikelen over de AI Pitch Competition, ook die van vorig jaar.
Vanaf het ontwerp rekening houden met de Europese AI Act
Wie in de Europese Unie actief is, moet voldoen aan strenge regels rond datasoevereiniteit en zich voorbereiden op de eisen die de Europese AI Act stelt aan toepassingen met een hoog risico.
‘Klantdata worden binnen de EU verwerkt, blijven onder controle van de klant en worden nooit gedeeld’, stelt Tomov. ‘De meeste van onze beelden tonen producten, gewassen en machines, waardoor het privacyrisico lager is dan bij de meeste AI-toepassingen. Medische beeldvorming vormt de uitzondering. Daar volgen we de strengere regels voor patiëntgegevens.’
De herleidbaarheid die inherent is aan het genereren van synthetische data, maakt het voldoen aan regelgeving bovendien tot een voordeel van het product: ‘Volgens de AI Act moeten systemen met een hoog risico, waaronder sommige medische hulpmiddelen en veiligheidscomponenten, aantonen dat hun trainingsdata representatief en goed gedocumenteerd zijn. Van elk synthetisch beeld dat we maken, kennen we de herkomst. Daardoor kunnen we de dataset nauwkeurig documenteren, wat onze klanten helpt aan die eis te voldoen. Vanaf dag één rekening houden met deze regels hoort voor ons bij het zijn van een Europees bedrijf.’
Brainport als springplank en de zoektocht naar rekenkracht en kapitaal
Met steun van OWOW Venture Studio en samenwerkingen met regionale partners als Fontys, SPARC en brabant.ai bevindt Synthgen zich midden in het Europese mechatronica-ecosysteem. Daarnaast werkt het bedrijf met Luxeed Robotics aan een agtech-project binnen de MIT-R&D-regeling van RVO.
‘Dankzij Brainport zitten veel van onze klanten op minder dan een uur rijden: machinebouwers, halfgeleider- en hightechbedrijven, voedingsmiddelen- en agtechbedrijven en de integrators die hun beeldherkenningssystemen bouwen’, zegt Tomov. ‘Mensen hier brengen je snel in contact met de juiste ingenieur.’
Tomov is echter ook open over de structurele nadelen waarmee Europese deeptech-startups nog altijd te maken hebben: ‘Wat nog ontbreekt, is kapitaal voor de vroege fase van deeptech-B2B-bedrijven met lange industriële verkooptrajecten, en GPU-rekenkracht binnen Europa tegen een prijs die startups kunnen betalen. Als Europa zijn eigen bedrijven voor fysieke AI wil, moeten beide hier beschikbaar zijn.’
Fysieke AI als het volgende strategische terrein
Gevraagd naar het bredere maatschappelijke debat over kunstmatige intelligentie laat Tomov de filosofische overdrijving achterwege. Hij richt zich op betrouwbaarheid in de praktijk en autonomie.
‘Het grootste deel van dit debat gaat over AI voor algemene doeleinden. Bij fysieke AI is de vraag concreter: doet het systeem betrouwbaar zijn werk? Een beeldherkenningsmodel op een productielijn herkent het gebarsten onderdeel of mist het, en je kunt meten wat er gebeurt. De omwenteling waar wij ons op richten, is AI betrouwbaar genoeg maken voor fabrieken, boerderijen en ziekenhuizen. Het risico dat wij voor Europa zien, is dat we voor die capaciteit afhankelijk worden van anderen, zeker nu dezelfde technologie haar weg vindt naar defensie en veiligheid.’
Met het oog op de pitchfinale op 12 november in het Evoluon is Tomov duidelijk over wat Synthgen onderscheidt:
‘We lossen een probleem op dat elk inspectieteam herkent: het zeldzame geval waarvoor je niet genoeg data kunt verzamelen. Fysieke AI wordt een van de grootste technologische verschuivingen van het komende decennium, en Europa heeft veel van wat daarvoor nodig is: fabrieken, boerderijen, ziekenhuizen en machinebouwers van wereldklasse. Wat ontbreekt zijn de data. We werken aan een helder doel: vanuit Brainport uitgroeien tot Europa’s toonaangevende bedrijf voor synthetische data voor fysieke AI.’
Erasmus Enterprise, BOM en IO+ organiseren de AI Pitch Competition, met steun van de provincie Noord-Brabant. De finale vindt plaats tijdens AI Summit Brainport op 12 november in het Evoluon in Eindhoven.